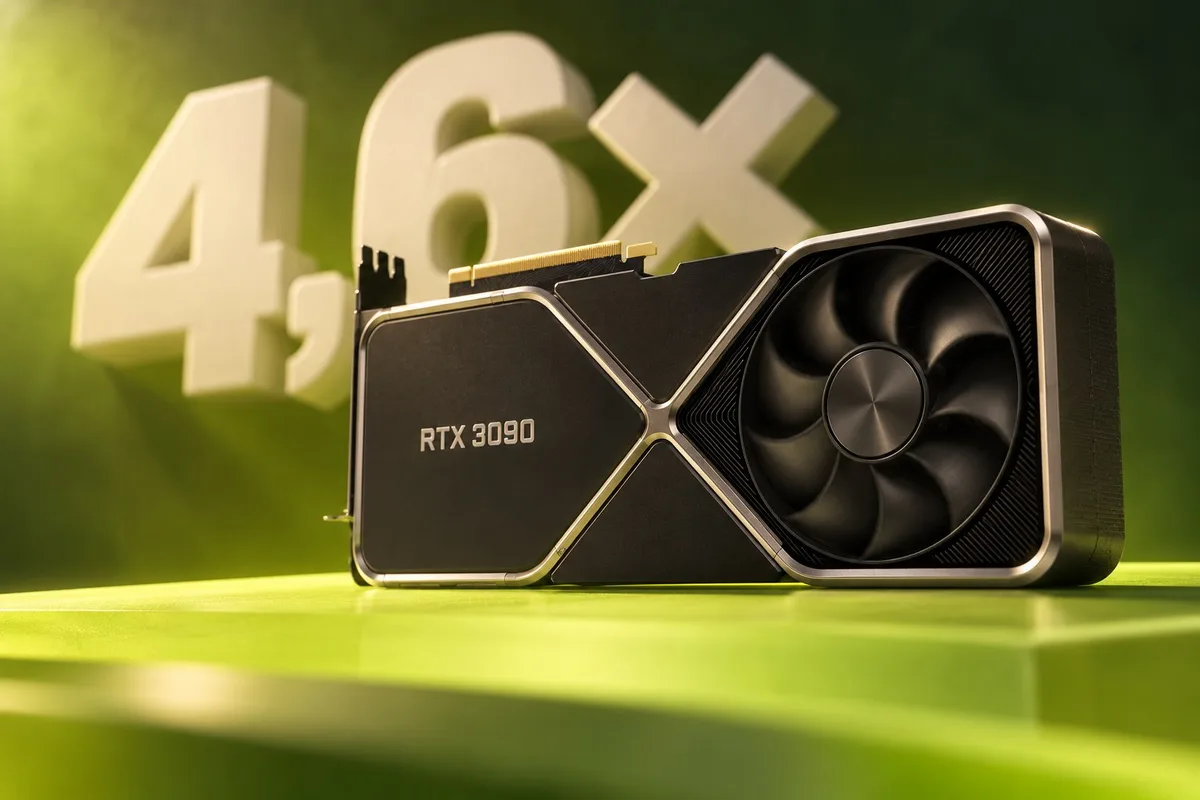
Un desarrollador ha multiplicado hasta por 4,6 la velocidad de generación de tokens de una RTX 3090 al ejecutar un LLM de 27B con optimizaciones de inferencia. El modelo, Qwen3.8-27B, pasó de 82 a 382 tokens por segundo (tok/s) con un motor de inferencia propio, sin cambiar de tarjeta ni de modelo. Las cifras son las que da el propio autor y no se han verificado de forma independiente.
La memoria frena a la RTX 3090 al generar con un LLM
La tarjeta de NVIDIA cuenta con un ancho de banda de memoria de 936,2 GB/s, suficiente para procesar prompts y generar tokens con soltura. El límite de la RTX 3090 está en sus 24 GB de VRAM, que dejan poco margen para un LLM grande.
Para entender el cuello de botella hay que ver cómo escribe un modelo: produce un token cada vez y cada uno depende del anterior. En cada paso, la GPU debe leer de la memoria los pesos, el enorme conjunto de conocimiento almacenado del modelo. Esa lectura, y no el cálculo en sí, marca el ritmo, así que el procesador gráfico pasa buena parte del tiempo parado. Es un problema parecido al de otras plataformas de IA local con la RTX Spark, donde la velocidad también se mide en modelos que corren en el propio equipo.
Al detectar ese freno, el usuario de Reddit «u/iamMess» recurrió a la decodificación especulativa. Un «borrador» rápido adivina varios tokens futuros y el modelo principal los comprueba todos en una sola pasada: conserva los correctos y descarta el resto. Es decir, en vez de validar una palabra, se valida la frase entera.
Como el modelo principal tiene siempre la última palabra, el resultado es idéntico al que habría escrito de todos modos. El desarrollador asegura que la precisión en una prueba de matemáticas se mantuvo en el 96,5 %.
Cómo se acelera un LLM con MTP y 16 tokens por paso en la RTX 3090
La velocidad subió por etapas. Primero ajustó la predicción multitoken (MTP) integrada en Qwen3.8-27B, que permite al modelo adivinar sus propios tokens siguientes, y eso elevó la velocidad con un solo usuario hasta unos 114 tok/s. Después sumó un segundo método de borrador, «DFlash2», que propone siete tokens por vez. Añadió también un borrador de «búsqueda», que rastrea en el texto de la conversación una coincidencia con lo recién escrito y supone que seguirán las mismas palabras.
- Base inicial: 82 tok/s
- Con MTP ajustado: unos 114 tok/s
- Con el borrador de búsqueda: 138 tok/s
- Citando un documento de 25.000 tokens: de 260 a 382 tok/s
- En un chat normal: unos 133 tok/s
El autor había dado por hecho que el paso de comprobación debía tener el mismo tamaño que los siete tokens de DFlash2, y no era así. El borrador de búsqueda rellena gratis los huecos sobrantes, de modo que el motor verifica ahora 16 tokens por paso. Cuando Qwen3.8-27B cita un documento, se aceptan unas 15 de esas 16 conjeturas.
El tuit que difunde el resultado habla de 381 tok/s y de un salto de 4,6 veces sin tocar la GPU ni el modelo, atribuido solo a la optimización de la pila de inferencia.
El mismo enfoque permitió ampliar la ventana de contexto hasta 138.696 tokens, al guardar la memoria de trabajo del modelo en un formato más compacto.
Los costes: menos ranuras y más espera al leer
Nada de esto es un truco gratuito. El paso de comprobación más largo consume la mitad de las ranuras de solicitud y 8.000 tokens de contexto, por lo que es opcional.
El formato compacto de memoria duplica el tiempo de lectura inicial de un documento. Encaja, por tanto, cuando se carga un texto una vez y se hacen muchas preguntas sobre él.
Fuera de las tareas que repiten texto, este modo funciona a aproximadamente la mitad de la velocidad del MTP simple. En el chat cotidiano, un LLM en la RTX 3090 alcanza unos 133 tok/s, todavía por encima de los 82 tok/s de partida.
Puedes seguir a HardwarePremium en Facebook, Twitter (X), Instagram, Threads, BlueSky o Youtube. También puedes consultar nuestro canal de Telegram para estar al día con las últimas noticias de tecnología.
Preguntas frecuentes
Pasa de 82 a 382 tok/s, una mejora de hasta 4,6 veces según el desarrollador. El tuit que la recoge cita 381 tok/s.
Con decodificación especulativa: borradores rápidos adivinan tokens y el modelo principal los verifica en una sola pasada. Se combinan el MTP del modelo, DFlash2 y un borrador de búsqueda que comprueba 16 tokens por paso.
Sí, a unos 133 tok/s frente a los 82 tok/s iniciales. Fuera de las tareas que repiten texto, el modo va a la mitad de velocidad que el MTP simple.
La comprobación de 16 tokens ocupa la mitad de las ranuras de solicitud y 8.000 tokens de contexto, y el formato compacto de memoria duplica el tiempo de lectura inicial de un documento. Además, las cifras no están verificadas de forma independiente.
 ¿Cyberpunk y RDR2 en una portátil? Estos son los FPS reales 🎮 #shorts
 1.399 € por la portátil más bonita de ASUS… ¿me compensa? 😅 #shorts
 ¿Cansado de llegar tarde a los chollos? ¡Está web te avisa antes!
 ¿8.000 Hz de verdad? Lo he medido 🔍 #shorts
 Una pantalla de 171" en unas gafas 🤯 ASUS ROG XREAL R1
Comentarios