
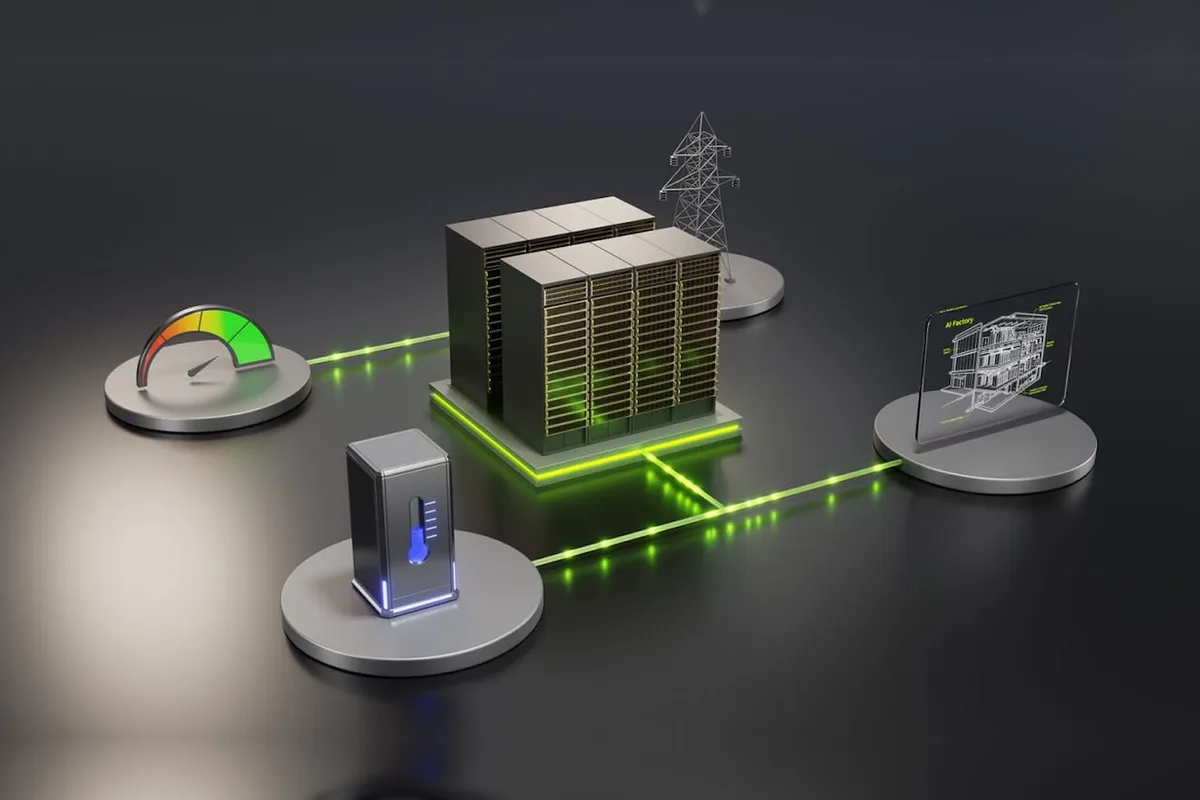
NVIDIA ha presentado mejoras de eficiencia energética en sus plataformas Vera Rubin para aumentar los tokens por megavatio. La compañía asegura que DSX MaxLPS puede elevar hasta un 40% el rendimiento de tokens por megavatio, mientras Lambda ha alcanzado 5 millones de tokens por segundo con un clúster ajustado al mismo presupuesto energético que utilizaba antes.
La demostración se produjo durante la AI Infra Summit. La demanda de inteligencia artificial ejerce una presión creciente sobre las redes eléctricas. Además, la respuesta de NVIDIA forma parte de una plataforma de fábrica de IA.
La plataforma combina sistemas Vera Rubin, software de inferencia Dynamo y bibliotecas NeMo. Además incluye soluciones de red: NVLink para escalar el procesamiento dentro del sistema, Spectrum-X para Ethernet y las SuperNIC ConnectX destinadas a conectar miles de nodos. También incorpora almacenamiento de memoria de contexto basado en BlueField y unidades DPU BlueField para la seguridad de la infraestructura.
DSX MaxLPS busca más tokens con el mismo límite energético
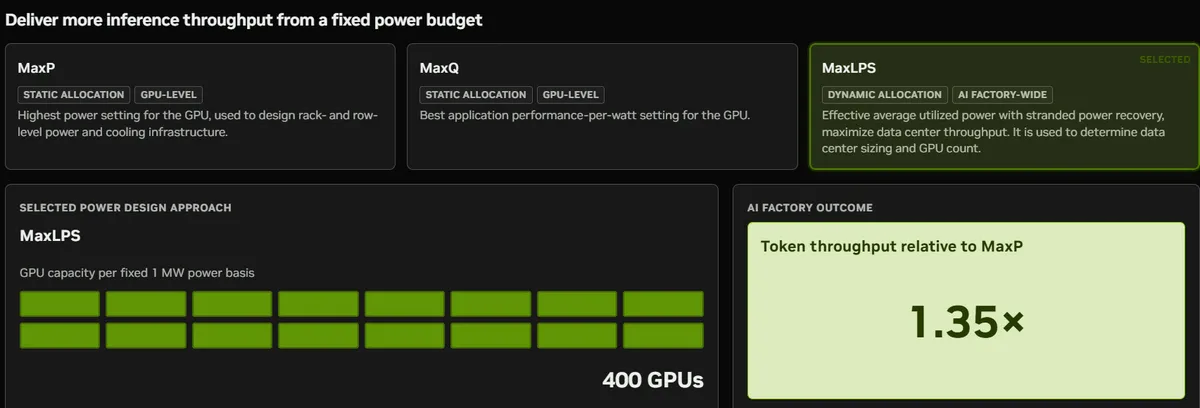
El objetivo de DSX es que una fábrica de IA produzca el mayor número posible de tokens. Sin embargo, no debe aumentar en la misma proporción el consumo eléctrico. NVIDIA cifra en hasta un 40% la mejora del rendimiento de tokens por megavatio que puede ofrecer DSX MaxLPS.
La tecnología ya se está utilizando en Conductor, la plataforma de Emerald AI. Además, su función no se limita a medir el consumo. DSX Flex modifica dinámicamente las necesidades de potencia del centro de datos según el estado de la red eléctrica.
Cuando la red entra en una situación de restricción, el sistema reduce la demanda. De hecho, así evita interrupciones durante cargas de IA críticas.
La fábrica ha recibido hasta ahora 200 señales relacionadas con el estado de la red. Según NVIDIA, ha respondido correctamente en todas las ocasiones. Además, lo hizo sin que el usuario tuviera que intervenir. Por tanto, el planteamiento convierte la disponibilidad eléctrica en una variable que el software puede gestionar junto con la carga de trabajo.
Los primeros resultados de proveedores en la nube apuntan a una mejora medible con un presupuesto fijo. Lambda, que ofrece capacidad GPU a más de 10.000 clientes, ejecutó el software en un clúster de cinco racks y 19 nodos.
La configuración mantuvo para 19 nodos el mismo presupuesto de potencia que antes utilizaban 16 nodos funcionando a plena capacidad. Por tanto, el resultado fue un 24% más de rendimiento de tokens en todo el clúster. Aproximadamente, fue 5 millones de tokens por segundo, frente a los cerca de 4 millones anteriores.
Lambda también registró una mejora del 23% en rendimiento por vatio.
Vera Rubin y Groq 3 LPX aumentan capacidad sin nuevas líneas eléctricas
NVIDIA extiende estas cifras a los racks basados en Vera Rubin y Groq 3 LPX. La compañía afirma que el mismo límite de potencia puede admitir hasta un 40% más de GPU. Además, puede alcanzar hasta un 35% más de rendimiento de tokens sin instalar nuevas líneas eléctricas.
En concreto, Vera Rubin busca maximizar los tokens por megavatio dentro del mismo marco de eficiencia. Por ejemplo, el objetivo es aprovechar al máximo los tokens por unidad de energía con esos racks.
Una de las mediciones procede de una carga Qwen 3.8 27B con un contexto de 100.000 tokens. En ese escenario, Groq 3 LPX alcanzó 2.529 tokens de salida por segundo y por usuario. Este margen permite que los agentes ejecuten más pasos de razonamiento y más llamadas a herramientas. Además, todo ocurre dentro del mismo presupuesto de respuesta, incluso cuando aumenta la escala de las cargas.
Resultados iniciales de CPU Vera Rubin
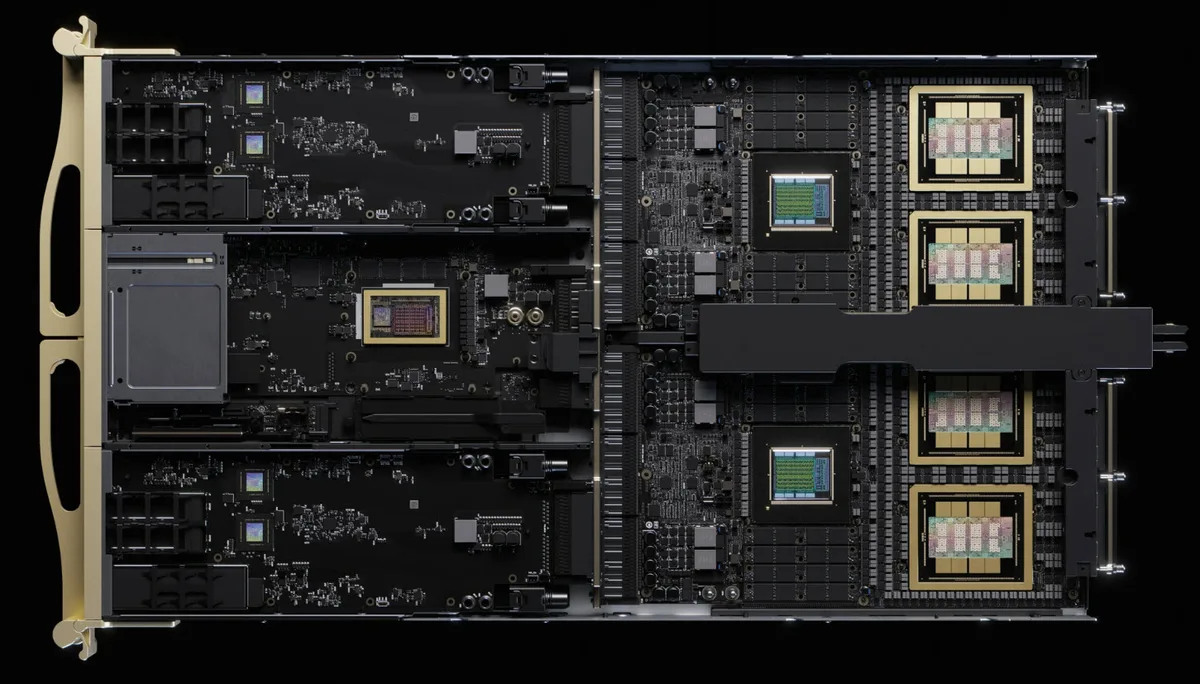
La publicación de NVIDIA también recoge resultados iniciales de varias empresas que han probado sus CPU Vera. Las compañías citadas informan de ganancias de hasta 1,9 veces. También mencionan latencias mucho menores y un 73% más de rendimiento. Además, hablan de una mejora de 3,3 veces en tareas de consulta frente a otras CPU.
Perplexity probó Vera en SPACE, su plataforma de entornos aislados seguros para IA agéntica. Además, midió arranques de sandbox 1,9 veces más rápidos. Daytona evaluó el procesador en cargas agénticas. En cambio, comunicó «ganancias serias para la ejecución agéntica».
ClickHouse compartió resultados obtenidos con Vera en ClickBench, su prueba abierta para bases de datos analíticas. Según el equipo, Vera fue la máquina más rápida que había medido hasta entonces. Además, sus resultados eran una «señal fuerte de lo que está por venir para el rendimiento de las CPU en cargas de trabajo intensivas en datos».
DeepInfra ejecutó varios benchmarks y situó a Vera por delante en todas las métricas. En concreto, señaló una latencia 2,2 veces menor en los pasos de orquestación. Prime Intellect observó un ancho de banda elevado y una latencia de memoria baja y estable. Por tanto, al ejecutar más cargas en paralelo, sugiere una ejecución predecible de aplicaciones agénticas.
Redpanda midió con Vera latencias 5,5 veces menores. También reportó un 73% más de rendimiento que con otras CPU. Starburst comunicó una velocidad de consulta tres veces superior. Kinetica, por su parte, registró un rendimiento de consultas analíticas 2,7 veces mayor frente a CPU tradicionales.
La métrica pasa de los FLOPS a los tokens por megavatio
La estrategia que NVIDIA y sus socios están planteando mide los centros de datos como fábricas de IA diseñadas conjuntamente. La referencia deja de ser únicamente el pico de FLOPS. Por tanto, pasa a incluir los tokens validados por megavatio. Esta métrica reúne capacidad de cálculo, software y disponibilidad energética.
En esa visión aparecen el trabajo de Annapurna con NVHBM. Además, incluye integraciones NVLink Fusion de d-Matrix. También forma parte del programa de carga flexible de Emerald AI con Silicon Valley Power. Asimismo, figuran mejoras reportadas en el texto: el 23% en rendimiento por vatio de Lambda con DSX MaxLPS, los sistemas visuales de Pinterest basados en Blackwell y Dynamo, el rendimiento 30 veces superior de Vera Rubin NVL72 en AgentX, la ventaja de latencia de Groq 3 LPX, los resultados de Vera CPU y la resistencia a escala de fábrica de NVLink 6.
El mensaje común es que el rendimiento no depende solo del silicio. NVIDIA sostiene que un sistema completo, desde los aceleradores y las CPU hasta el software y la conexión con la red eléctrica, puede extraer más tokens. Además, puede proteger las cargas prioritarias y aprovechar mejor cada megavatio.
En los datos comunicados, ese aprovechamiento se traduce en más capacidad con una infraestructura eléctrica limitada. Por ejemplo, implica un coste menor por token y más valor económico para las próximas generaciones de centros de datos de IA. La prueba de Lambda aporta el resultado más concreto: pasar de unos 4 millones a 5 millones de tokens por segundo con el mismo presupuesto de potencia que antes sostenía 16 nodos.
Puedes seguir a HardwarePremium en Facebook, Twitter (X), Instagram, Threads, BlueSky o Youtube. También puedes consultar nuestro canal de Telegram para estar al día con las últimas noticias de tecnología.
FAQ
Lambda ejecutó el software en un clúster de cinco racks y 19 nodos. Esos 19 nodos funcionaron con el mismo presupuesto energético que 16 nodos a plena potencia.
El clúster pasó de aproximadamente 4 millones a 5 millones de tokens por segundo. La mejora comunicada fue del 24% en rendimiento total y del 23% en rendimiento por vatio.
Ajusta de forma dinámica las necesidades de potencia del centro de datos según las condiciones de la red. NVIDIA indica que ha procesado 200 señales sin intervención del usuario y sin interrupciones en las pruebas citadas.
Perplexity, Daytona, ClickHouse, DeepInfra, Prime Intellect, Redpanda, Starburst y Kinetica aparecen entre las compañías que han comunicado mediciones. Sus pruebas cubren entornos aislados, ejecución agéntica, bases de datos analíticas y consultas.
 ASUS VG27UQEL5A: el dual mode asequible que promete mucho
 Windows PUNTÚA tu PC y casi nadie lo sabe 😱
 Los NUEVOS volantes de MOZA con Mercedes, Porsche y Ford
 ASUS ROG Spatha X 65K: ¡12 BOTONES y 65.000 DPI! 🔥 #Shorts
 ASUS ROG celebra 20 AÑOS con esta ROG ALLY X20 🔥 | Gamescom 2026 #Shorts
Comentarios