
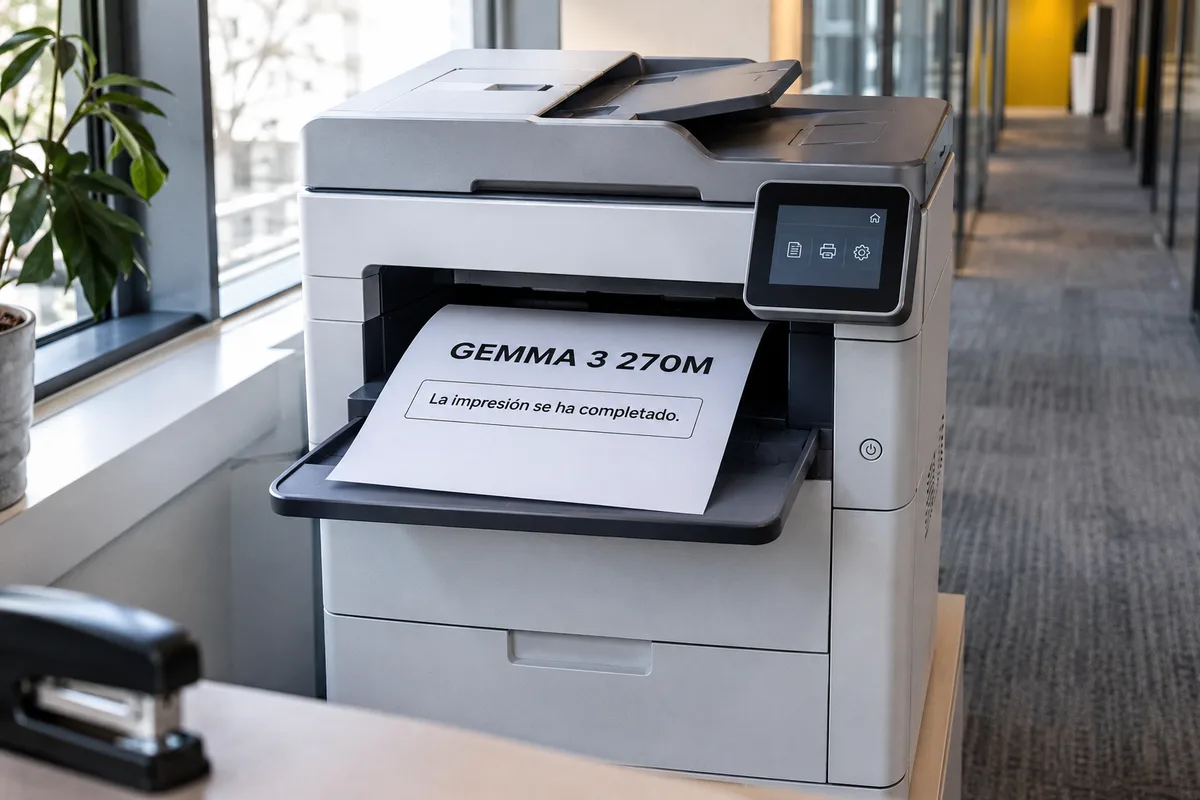
Un ingeniero de Google DeepMind ha conseguido ejecutar Gemma 3 con 270 millones de parámetros en una impresora láser de oficina. El equipo solo disponía de 14 MB de RAM. Omar Sanseviero ha mostrado la prueba en X. El modelo cuantizado trabajó dentro de la propia impresora, con 61,3 tokens por segundo en su CPU y un consumo máximo de 14,1 MB.
Hay precedentes de IA en hardware inesperado, como cuando alguien hizo funcionar un LLM de 3.000 millones de parámetros en un Pixel 7. Los modelos pequeños caben en equipos con una memoria mucho más corta, y esta vez una impresora de oficina rindió con decencia. Más que un camino para equipos baratos, el experimento demuestra hasta dónde se puede estirar el hardware: encaja con una época de RAM carísima, pero no la resuelve, porque el modelo es de solo 270 millones de parámetros y está cuantizado.
Gemma 3 cabe en un solo archivo PostScript, sin tocar el firmware
«Con la ayuda de Carbon, ejecuté Gemma directamente en una impresora de oficina», escribe Sanseviero. No modificó el firmware ni añadió placas de cómputo externas. Todo el montaje descansa en PostScript, el lenguaje de descripción de página, Turing completo, que llevan integrado las impresoras láser actuales.
Carbon es un motor ligero de inferencia para transformers. Combinado con una versión cuantizada de Gemma 3 y sus 270 millones de parámetros, dio como resultado un único archivo de impresión PostScript en bruto.
El pico de RAM se queda en 14,1 MB al rotar las capas
Para que la impresora no agotara su memoria durante la inferencia, el sistema recurrió a la carga dinámica por capas: las iba metiendo y sacando de la RAM por turnos. Así, el pico se mantuvo en 14,1 MB de los 244,6 MB de memoria virtual PostScript asignados. El truco de rotar las 18 capas para mantener el pico tan por debajo de la memoria asignada, sin tocar el firmware, es lo que tiene verdadero mérito de la prueba.
La impresora imprime la respuesta de Gemma 3 tras 184 segundos
Según el recibo de hardware impreso que aparece fotografiado junto a la unidad Ricoh, la ejecución completa tuvo lugar de forma nativa en el intérprete PostScript Level 3 de la impresora, a lo largo de 18 capas del transformer.
La entrada era un prompt de cuatro tokens, «Read the fine». La fase de prefill llevó 184 segundos y decodificar un único token, 0,1 segundos, hasta sumar 184 segundos en total.
Los 61,3 tokens por segundo dicen poco si el prefill se come todo el tiempo.
El prefill y la decodificación son fases distintas de la inferencia. En el prefill, el modelo procesa de una vez todos los tokens del prompt y rellena la caché de atención. Después, en la decodificación, genera la respuesta token a token, y cada paso reutiliza esa caché.
Cuando terminó el cálculo en la pila de PostScript, la impresora sacó en papel la respuesta completa, «Read the fine print». Con ello, la demostración muestra que un equipo de oficina corriente puede ejecutar inferencia de IA en local si se fuerza su software.
Google no ha planteado ningún uso real, y el experimento interesa más a quien disfruta de estos inventos que a una oficina. Que una impresora pueda ejecutar código arbitrario a través de PostScript, además, abre una pregunta de seguridad.
Puedes seguir a HardwarePremium en Facebook, Twitter (X), Instagram, Threads, BlueSky o Youtube. También puedes consultar nuestro canal de Telegram para estar al día con las últimas noticias de tecnología.
Preguntas frecuentes
En una unidad Ricoh de oficina. Su intérprete PostScript Level 3 procesó de forma nativa las 18 capas del modelo, según el recibo de hardware impreso que acompaña a la demostración.
No. Sanseviero no cambió el firmware ni conectó placas externas: generó con Carbon un archivo de impresión PostScript en bruto y lo envió a la impresora.
 5 errores con los ventiladores que asan tu PC 🔥
 8.000 Hz en un mando… ¿se nota de verdad?
 Por fin un mando que acaba con el drift 🕹️
 Este mando cabe en el bolsillo… y es una consola 🎮 Razer Prio
 ¿Se puede jugar en un portátil ARM? Lo he probado 🎮🤯 #shorts
Comentarios