
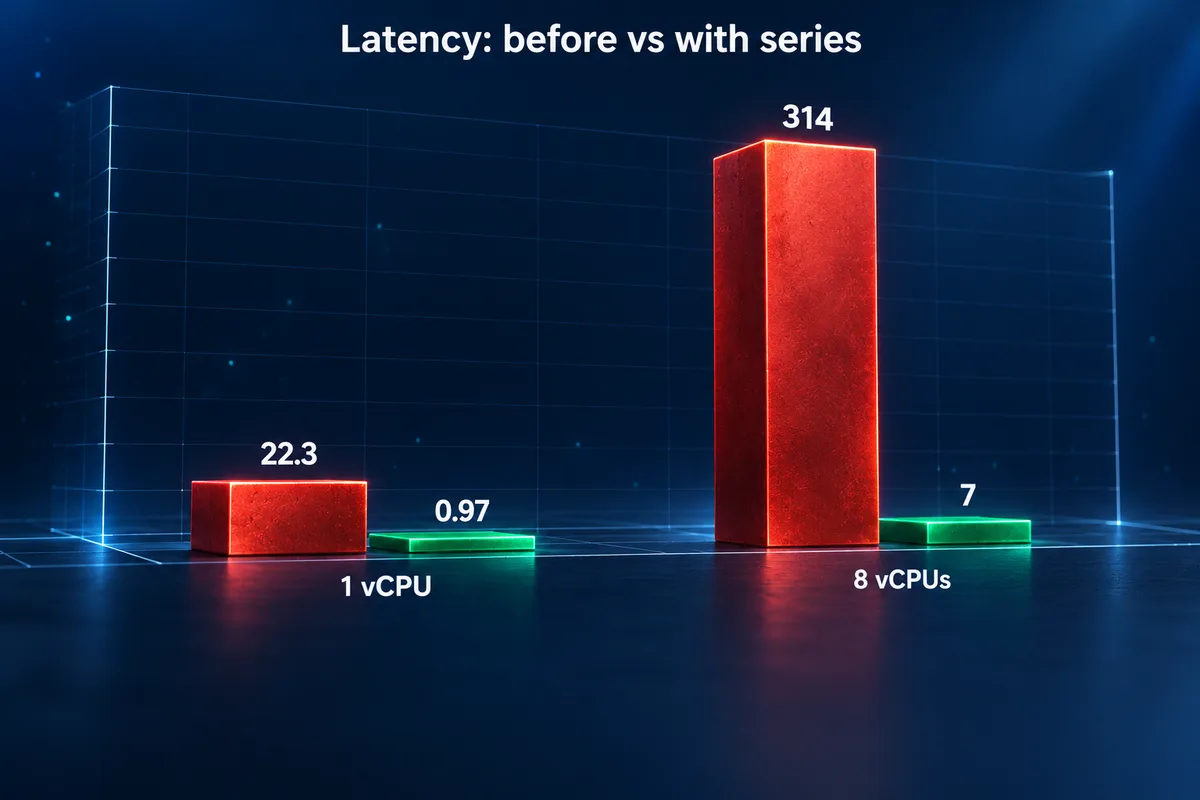
Un nuevo conjunto de parches para zswap en el kernel Linux separa las peticiones y los mutex de compresión y descompresión, de modo que las cargas ya no esperan a las escrituras. Las mediciones incluidas con la serie muestran una caída drástica de la latencia en las lecturas más lentas, tanto con 1 vCPU como con 8.
Las lecturas de zswap en Linux ya no esperan a las escrituras
El problema es una inversión de prioridades. Las escrituras y las lecturas comparten por CPU una petición acomp y un mutex, así que una escritura de baja prioridad puede ser desalojada justo después de que el compresor suelte el bloqueo de su flujo, cuando aún retiene el mutex de zswap. Una lectura de mayor prioridad en esa misma CPU queda entonces a la espera de que la escritura vuelva a ejecutarse. La serie de parches de zswap para Linux sigue el trabajo de Sergey Senozhatsky en zram, que separa esas estructuras por el mismo motivo.
Los cambios se reparten en dos parches y un coste de memoria:
- El primer parche da a la compresión y a la descompresión peticiones, esperas y mutex propios. Las lecturas dejan de esperar a las escrituras, aunque siguen pudiendo esperarse entre sí.
- El segundo descomprime con una petición en la pila cuando el algoritmo es síncrono y no necesita contexto de petición, lo que abarca todos los compresores por software incluidos en el kernel. Esas lecturas no toman ningún bloqueo de zswap.
- Los algoritmos asíncronos conservan la petición y el mutex por CPU.
- Con compresores por software se reserva el mismo número de peticiones que antes, pero cada contexto por CPU crece 72 bytes y la ruta de lectura es unos 270 bytes más profunda en x86-64.
Con 8 vCPUs, la lectura más lenta pasa de 314 a 7,0 ms
Las cifras recogen la lectura más lenta de cada ejecución, como mediana (mínimo-máximo) de 5 ejecuciones de 12 segundos en una máquina virtual con zstd, preemption perezosa, vm.page-cluster=0 y swap en /dev/ram0. En la prueba monoprocesador, cuatro procesos con nice +10 vuelcan memoria a swap y la releen mientras una tarea con nice 0 consume CPU en bucle. Un lector con nice -19 expulsa su propio búfer y mide cuánto tarda cada lectura. Con 8 vCPUs hay 16 procesos de trabajo, 8 tareas en bucle y 8 lectores.
Las lecturas de más de 10 ms pasaron de 26-35 por ejecución a ninguna en la prueba monoprocesador, y de 3-18 por ejecución a una como máximo con 8 vCPUs. El banco de pruebas y los programas de test se escribieron con ayuda de un LLM. Es un parche más en la línea de otros recientes del kernel, como el parche que mejora los FPS bajos en la Steam Deck, orientados a reducir la latencia en el caso peor.
Puedes seguir a HardwarePremium en Facebook, Twitter (X), Instagram, Threads, BlueSky o Youtube. También puedes consultar nuestro canal de Telegram para estar al día con las últimas noticias de tecnología.
Preguntas frecuentes
Una escritura de baja prioridad puede ser desalojada mientras retiene el mutex de zswap, y una lectura de mayor prioridad en esa CPU espera a que vuelva a ejecutarse. La serie separa las peticiones y los mutex de compresión y descompresión.
Con 1 vCPU baja de 22,3 ms a 0,97 ms de mediana. Con 8 vCPUs pasa de 314 ms a 7,0 ms.
Los síncronos que no necesitan contexto de petición, lo que incluye todos los compresores por software del kernel. Los asíncronos mantienen la petición y el mutex por CPU.
Cada contexto por CPU crece 72 bytes y la ruta de lectura es unos 270 bytes más profunda en x86-64. El número de peticiones con compresores por software es el mismo que antes.
 Una pantalla de 171" en unas gafas 🤯 ASUS ROG XREAL R1
 Logitech PRO X2 RAPID: teclado analógico con Rapid Trigger y pantalla OLED ¿Vale 229 €?
 Este portátil no lleva Intel ni AMD: lleva un chip ARM de Qualcomm, y eso lo cambia todo. 💻⚡
 Probamos el nuevo Logitech G PRO X3 Superstrike en el evento de Logitech en Madrid 🖱️🔥
 Bambu Lab R1: ¡55 W de potencia láser! 🔥 #Shorts
Comentarios